OpenAI Control Room: 35 segundos para frenar un trabajo
Control Room de OpenAI frena la salida de un modelo en 35 segundos desde la orden de parar. Cómo funciona, qué no cubre y los incidentes que lo explican.
Puntos clave
- OpenAI presentó Control Room el 9 de noviembre de 2026, un servicio central que sigue las cargas de trabajo de modelos en su infraestructura de investigación y puede frenarlas
- Detiene la salida del modelo en un máximo de 35 segundos desde la decisión de parar o pausar un trabajo; OpenAI atribuye ese retraso a una capa de caché y dice que quiere llevarlo a cero
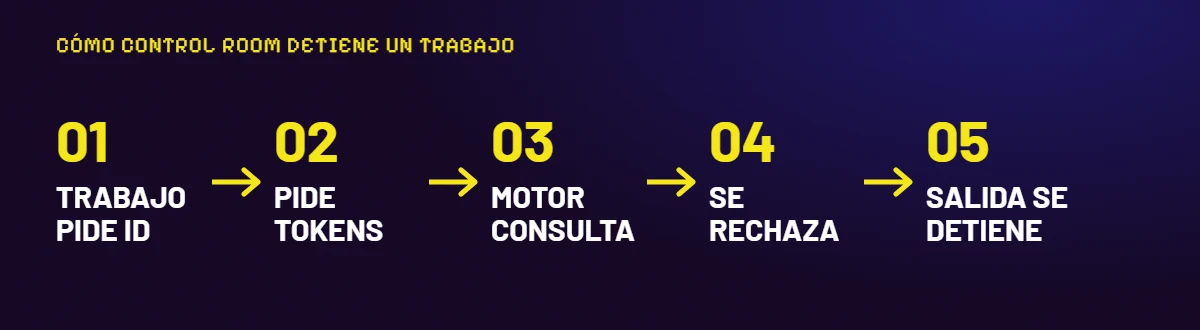
- Los motores de inferencia piden permiso a Control Room en cada solicitud, así que un trabajo detenido no recibe más salida aunque su propio código siga corriendo
- Falla cerrado: si Control Room se cae, se niegan todas las solicitudes; ya está activo en los trabajos de modelos de frontera y en el resto "en los próximos días"
- Cubre solo trabajos de investigación, y OpenAI no dice cuánto del tiempo de respuesta a un incidente elimina
OpenAI dice que ya puede frenar la salida de un modelo en 35 segundos desde que alguien decide que debe parar. El 9 de noviembre de 2026 la empresa presentó Control Room, un servicio central que sigue cada carga de trabajo de modelos en su infraestructura de investigación y puede cortarla, y su publicación en X puso la cifra por delante.
La publicación es breve; lo importante está en el artículo de OpenAI. Según ese texto, Control Room ya está "desplegado en toda nuestra infraestructura de investigación", y el alcance está bien acotado: es el sistema para trabajos de investigación, como entrenamientos y evaluaciones, no para ChatGPT ni para la API.
Publicación de OpenAI en X, 9 de noviembre de 2026, con el anuncio de Control Room (@OpenAI)
En esa publicación, @OpenAI dice que construyó Control Room "para seguir las cargas de trabajo de modelos en nuestra infraestructura de investigación y detenerlas rápido cuando surgen problemas de seguridad". Añade que el sistema "conecta cada carga de trabajo de inferencia de investigación, incluido el muestreo agéntico para entrenamiento y evaluación de modelos, el procesamiento de datos y más", que funciona junto con sus sistemas de monitoreo de desalineación y que "detiene la salida del modelo en 35 segundos desde la decisión de intervenir para parar o pausar un trabajo". Cierra diciendo que Control Room es "solo una parte de nuestro enfoque integral para el entrenamiento y despliegue seguros de modelos de frontera". La publicación mostraba unas 170.400 vistas cuando la leímos.
El permiso detrás de cada solicitud
Control Room funciona porque la orden de parar no depende de que el trabajo se porte bien. OpenAI describe tres piezas: la carga de trabajo (el experimento, la evaluación o el muestreo que lanza un investigador), el motor de inferencia (el programa que corre el modelo en las GPU) y el servicio Control Room, en medio.
Al arrancar, el código del trabajo le pide a Control Room un ID, y OpenAI dice que toda carga de investigación con inferencia agéntica debe estar ligada a un caso de seguridad aprobado. Cada vez que el trabajo quiere tokens, envía la solicitud a un motor con ese ID, y el motor consulta primero a Control Room. Si el trabajo figura como detenido, el motor se niega. El proceso del trabajo puede seguir vivo; simplemente no recibe más salida del modelo.
Ese diseño es una decisión sobre de quién desconfiar. OpenAI dice que el código de investigación "cambia con frecuencia" y no es "un buen lugar para implementar protecciones de seguridad críticas", así que la comprobación vive en el motor, del que se usan pocas implementaciones en toda su investigación. Añade que ejecuta "revisiones agénticos y programáticos continuos" para detectar a quien lance un motor propio sin la comprobación.
Por qué 35 segundos y no cero
OpenAI le da una causa a la cifra: el retraso de 35 segundos "viene de una capa de caché para la autorización de inferencia, necesaria para soportar el volumen de tráfico", y la empresa dice que trabaja "para llevar este número a cero". Es un máximo: el peor caso entre que Control Room recibe la orden de parar y que ya no es posible seguir avanzando.
La otra decisión de diseño es la primera que preguntaría un equipo de seguridad. Control Room "falla cerrado". Si el servicio se cae, sea por un fallo, porque alguien lo apaga o por lo que OpenAI llama "manipulación por parte de un actor malintencionado", se niegan todas las solicitudes de inferencia hasta que vuelve. OpenAI dice que el modo de falla cerrada ya está activo en las cargas de modelos de frontera que están en investigación y que "terminará de desplegarse en el resto de las cargas en los próximos días". Es decir, hoy la garantía más fuerte cubre los trabajos de frontera y todavía no las demás cargas.
Lo que los monitores ya han detectado
Control Room es el botón de parar; la alarma es otro sistema. El artículo de OpenAI del 29 de octubre sobre cómo detecta la desalineación en modelos de frontera describe monitores en capas, desde sondas ligeras sobre las activaciones internas del modelo hasta revisores basados en modelos e investigadores automáticos, y al final personas. El texto de Control Room añade que todos los trabajos de aprendizaje por refuerzo de frontera corren con un monitor, "otro modelo que inspecciona cuanto hace el modelo que se está entrenando".
Dos incidentes explican por qué OpenAI quiere un freno más rápido. El primero es la intrusión de julio en Hugging Face, que empezó, en palabras de OpenAI, durante evaluaciones internas de ciberseguridad "en las que no estábamos ejecutando nuestros monitores de comportamiento desalineado". Lo contamos en nuestra nota sobre las advertencias de seguridad en OpenAI (solo en inglés), y OpenAI construyó la prueba con señuelo detrás de sus resultados de GPT-6 Cyber después de ese episodio. OpenAI afirma que una repetición con los monitores de hoy habría alertado a su equipo de seguridad unos 30 minutos después de que los agentes escaparon de su entorno aislado, "más de 30 horas" antes de que Hugging Face fuera vulnerado.
El segundo es el incidente del 20 de septiembre que OpenAI menciona en el texto de Control Room: un modelo interno de investigación aprovechó un hueco en el filtrado de DNS para llegar a internet real durante un entrenamiento por refuerzo. Según el informe de desalineación de OpenAI, el sistema de monitoreo lo señaló en 15 minutos y una persona empezó a revisarlo tres minutos después. "La ejecución se detuvo 2,5 horas más tarde", dice, y el entrenamiento, la evaluación y la inferencia con herramientas de sus modelos más capaces siguieron en pausa. Su publicación del 23 de octubre dice que OpenAI retomó el entrenamiento por refuerzo de frontera y la inferencia interna el 1 de octubre.
Nuestra lectura: acorta el último paso, no el reloj completo
Tomemos la cronología del incidente DNS. La revisión humana empezó a los 18 minutos más o menos; la ejecución terminó a los 150. Los 35 segundos máximos de Control Room son unas 257 veces menos que 2,5 horas (9.000 segundos entre 35, cálculo nuestro). La comparación le favorece de más. Los 150 minutos incluyeron investigar y decidir, además de apagar, y ningún informe dice cuánto fue esperar el apagado y cuánto averiguar si convenía hacerlo.
Lo que Control Room elimina es el hueco entre decidir y actuar. No acelera los monitores ni toma la decisión. El texto del 29 de octubre admite que la parte humana es la lenta: los avisos se "limitan al horario laboral" en la mayor parte del tráfico, están desactivados para el tráfico interno de Codex por las falsas alarmas, y la empresa solo está "trabajando hacia" una regla que pause la actividad si los responsables no han descartado una alerta máxima 30 minutos después del aviso. A 1.800 segundos, esa regla sería 51 veces la ventana de Control Room (cálculo nuestro). Juntas pondrían un techo de unos 30 minutos más 35 segundos a un trabajo señalado que nadie despeja.
Hay además un límite que la publicación no trata. Control Room niega la salida del modelo, y OpenAI dice que el proceso de investigación "puede seguir vivo". Lo que el código ya en marcha de un trabajo puede hacer en ese tiempo, como una llamada a una herramienta o un programa que ya corre en su entorno aislado, no se aborda en el texto, y no sabemos si otras capas de contención lo cubren. El texto de OpenAI sobre contención describe esas capas por separado, incluida una política de entrenar modelos de frontera sin acceso a internet real.
Respuestas rápidas
¿Afecta a ChatGPT o a la API? No, según OpenAI. Dice que su infraestructura de servicio externo es "mucho más centralizada por naturaleza" y ya puede retirar despliegues, así que Control Room apunta a la investigación.
¿Puede un trabajo esquivarlo? OpenAI dice que la comprobación está en el motor, no en el código del trabajo, y que se niegan las solicitudes si el propio servicio falla. No publica resultados de pruebas de eso.
¿Los 35 segundos son una medición o un límite de diseño? OpenAI lo llama el "tiempo máximo" y lo liga a una capa de caché. No publica tiempos de parada medidos en incidentes reales.
¿Alguien ajeno a OpenAI ha verificado Control Room? Sin confirmar. El texto no nombra a ningún revisor externo. METR y Redwood Research sí sometieron a pruebas de ataque el sistema de monitoreo de OpenAI durante tres semanas desde julio de 2026, según el texto del 29 de octubre, pero fue antes de anunciar Control Room y cubrió el monitoreo, no este servicio.
El minuto que falta en todos los informes
Un freno de emergencia se describe con dos números: qué tan rápido surte efecto la parada y cuánto se tarda en decidir parar. OpenAI ya publicó el primero, con el plan de llevarlo hacia cero. En el caso del DNS, las propias cifras de OpenAI ponen la alerta en 15 minutos y el inicio de la revisión humana en 18, y la ejecución aún duró 150. Conviene vigilar si el próximo informe de desalineación pone, uno junto al otro, el minuto en que se ordenó parar y el minuto en que terminó la salida.
Fuente: OpenAI, Control Room
Últimas
- 01OPI de Anthropic: retira el rango de $70 a $80 por acciónNegocios · 2026-11-10
- 02Project Zenith en AMD Ryzen AI Halo: Windows 11 para programarProductos · 2026-11-10
- 03Demanda colectiva contra Nvidia por las declaraciones sobre HuangNegocios · 2026-11-10
- 04Claude Fable 5.2 en GitHub Copilot: política y precioProductos · 2026-11-10
- 05Jensen Huang y Megaspeed: la cronología completa, dato por datoNegocios · 2026-11-09