DeepSeek Harness propõe super agente de IA sempre ativo
A equipe do DeepSeek Harness propõe um agente de IA sempre ativo para tocar várias tarefas no chat e no GitHub. É só uma proposta, com testes simulados.
Pontos principais
- Um Router sempre ativo conversa com as pessoas, e vários Workers isolados executam as tarefas
- Eventos de chat, e-mail e CI chegam em fluxo contínuo, e filtros baratos fazem a triagem antes de qualquer modelo
- No teste simulado da equipe, o desenho concluiu as tarefas mais rápido que uma única sessão, mas gastou mais tokens
- É uma proposta e um plugin protótipo, não um recurso lançado pelo DeepSeek
- Ninguém de fora da equipe replicou os resultados
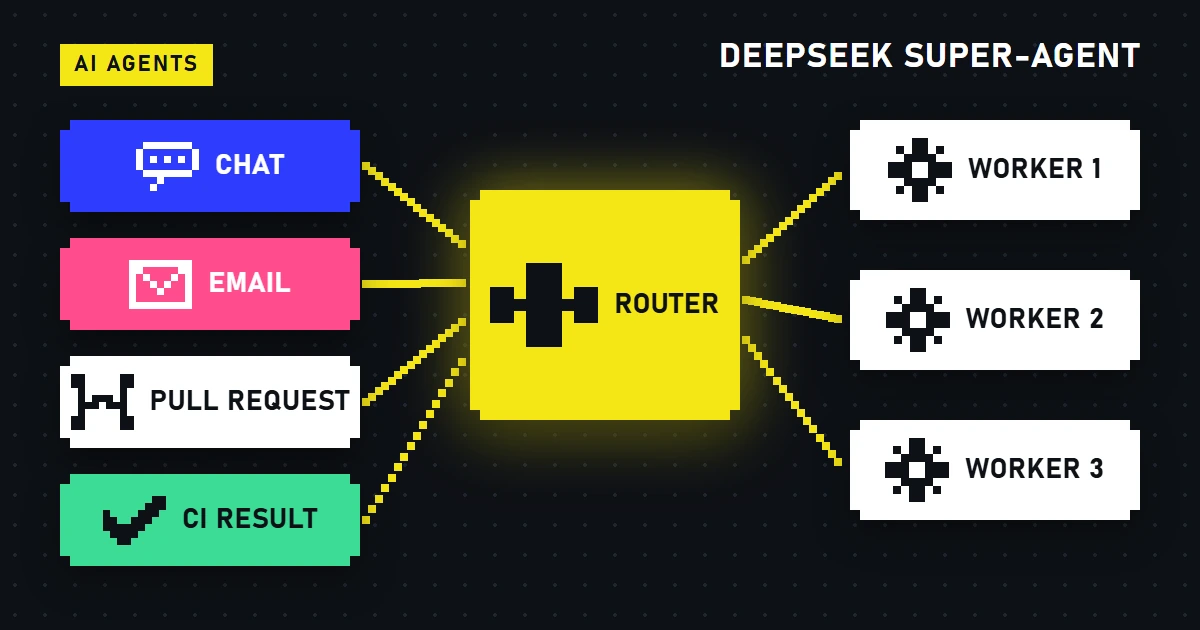
Um agente de IA sempre ativo, que acompanha o chat da equipe e age sem que ninguém o chame: é essa a aposta do Super-agent, novo ensaio de design da equipe do DeepSeek Harness. Imagine que um relato de bug cai no grupo. Ninguém responde, ninguém abre chamado. Tempos depois, chega uma mensagem dizendo que o problema foi reproduzido e que há uma correção simples. Segundo a equipe, é mais ou menos assim que o agente interno dela já funciona.
O ensaio, escrito em chinês e divulgado no X, propõe um "Super-agent": um único agente de IA que nunca se desconecta, acompanha chats, e-mails, comentários no GitHub e resultados de CI e mantém várias tarefas andando ao mesmo tempo. O Harness é o framework de código aberto do DeepSeek para agentes. De acordo com a equipe, uma versão interna do Super-agent já ajuda a reproduzir bugs, responder a revisões de código e até a desenvolver o próprio Harness.
Um aviso antes dos detalhes: trata-se de uma proposta, não de um lançamento. A publicação ressalta que o texto não descreve recursos atuais do Harness e que o plugin de código aberto divulgado junto, o dsh-superagent-prototype, é um experimento, não um produto oficial do DeepSeek.
Publicação do DeepSeek Harness que leva ao ensaio de design (@DeepSeekHarness)
Um framework recente diante de concorrentes de peso
O Harness é recente. O DeepSeek lançou a v0.1 em 13 de agosto, como ambiente de execução de código aberto para criar agentes de programação, junto com a disponibilidade geral do modelo V4-Pro, segundo o RuntimeWire, que cita o VentureBeat. A mesma reportagem compara o Harness ao Claude Code, da Anthropic, e ao Codex, da OpenAI, e informa que o reajuste de preço do V4-Pro passa a valer em 16 de agosto. A HPCwire descreveu o lançamento como uma prévia para desenvolvedores.
Ou seja, a equipe já pensa no próximo passo de um framework aberto ao público há poucos meses. A contagem de plugins, cerca de 35 mil segundo o DeepSeek, está no nosso último levantamento sobre a comunidade de plugins do Harness (em inglês). A versão candidata mais recente, que analisamos em o que o Harness 0.2.2 muda por padrão (em inglês), mostra quanta coisa ainda está mudando. A ideia também acompanha um movimento maior do setor: em abril, a equipe de engenharia da Anthropic publicou o Scaling Managed Agents, que descreve um harness sem estado, separado dos sandboxes onde as ferramentas rodam. Os objetivos são diferentes, mas a direção é a mesma: tirar o loop do agente de qualquer máquina ou sessão específica.
Hoje, o gargalo é a atenção humana
Os agentes de programação atuais já tocam tarefas longas com pouca supervisão. O problema, para a equipe, está no entorno. Pela experiência dela, uma pessoa consegue acompanhar de três a cinco sessões de agente ao mesmo tempo, e cada sessão é uma ilha: é preciso ficar pulando de uma para outra, tentando lembrar o que cada uma estava fazendo.
Ferramentas de linha de comando ou servidores MCP não resolvem, argumenta a publicação. Uma sessão única continua travando em operações lentas, misturando tarefas sem relação e saindo do ar quando o notebook entra em repouso. Por isso, a proposta é tirar o agente da sessão de vez.
Um Router na frente, vários Workers atrás
O desenho tem duas camadas. Na de cima fica o Router, uma sessão de longa duração que cuida de todas as conversas com pessoas. Ele não executa as tarefas: funciona como uma central telefônica com memória e, segundo o ensaio, em geral um modelo mais leve e barato dá conta do recado. Na de baixo, os Workers pegam as tarefas de fato, cada um em sua própria sessão isolada, com o conjunto completo de ferramentas e o modelo mais forte disponível. Eles nunca falam com as pessoas: reportam ao Router, e é o Router que escreve todas as respostas.
Isso difere do padrão de "equipe de agentes", em que um agente líder divide uma tarefa grande em subtarefas fortemente ligadas entre si. Aqui, o Router apenas distribui trabalhos independentes e acompanha como eles se relacionam. Na implantação da própria equipe, o Router é uma única sessão de LLM mantida sempre ativa.
Por que a maioria das mensagens nem chega a um modelo
O agente não fica esperando instruções. Ele acompanha um fluxo de eventos: mensagens de grupos de chat, e-mails, lembretes de agenda, comentários de revisão, resultados de CI. Como chats e plataformas de código geram muito ruído, um código comum faz primeiro uma triagem barata, e só os candidatos mais prováveis chegam a um modelo de linguagem, que aplica regras escritas em linguagem natural, as quais qualquer pessoa pode reescrever quando quiser.
Quando um Worker assume uma conversa, como um pull request, os eventos seguintes dela vão direto para ele, sem nova chamada ao Router. Para evitar que o contexto cresça demais, o sistema trata a memória do modelo como um cache: mantém à vista os detalhes que provavelmente serão necessários e guarda referências para voltar a tarefas mais antigas. A equipe chama isso de Chain of Recall.
Duas escolhas menores chamam a atenção. Chamadas longas a ferramentas rodam em segundo plano e devolvem "Started" na hora, de modo que o agente segue respondendo enquanto o trabalho continua. (Segundo a equipe, o Harness já tem esse recurso, mas o deixa desativado por padrão.) Além disso, o loop do agente roda em contêineres sem estado na nuvem, enquanto repositórios e credenciais ficam na máquina do usuário.
Mais rápido, porém mais caro em tokens
Os números do teste vêm com uma ressalva importante, que a própria equipe destaca logo de saída: cargas sintéticas, configurações simplificadas e cinco execuções por desenho. Cada desenho processou cerca de 300 mensagens de grupo de chat e de CI do GitHub, das quais uns 20 eram pedidos reais; o trabalho de programação foi simulado por uma ferramenta que apenas gasta tempo.
Nesse teste, a tarefa mediana do Super-agent levou 12,4 minutos, e os casos mais lentos, 15,7. Uma sessão única com ferramenta de subagente levou 20,4 minutos (29,5 nos piores casos) com um prompt neutro e 13,8 (29,0) quando foi instruída a delegar primeiro. Com o prompt neutro, o modelo não delegou em nenhuma das cinco execuções. Com o prompt de delegação, delegou em quatro; na quinta, avaliou que a tarefa era pequena e a fez sozinho, o que esticou os piores casos.
A rapidez tem custo. O Super-agent consumiu 23,2 milhões de tokens de leitura de cache por execução, contra 6,1 milhões e 10,8 milhões nas configurações de sessão única. Desligar o repasse direto aos Workers não mudou o tempo de conclusão, mas elevou as decisões do Router em cerca de 30% e os tokens em aproximadamente 37%, para 31,8 milhões. Em um teste de estresse à parte, com Workers simulados, o tempo por pedido subiu de apenas 2,5 para 3,9 segundos, enquanto os eventos que exigiam decisão passaram de cerca de 1 para cerca de 40 por minuto. Com isso, a equipe conclui que uma única sessão de Router basta no tamanho atual.
Onde a ideia pode falhar
A publicação é franca sobre o que ainda não resolveu. Ninguém sabe quando o Router deve ser dividido nem quando os Workers devem conversar entre si. A memória de longo prazo, ao longo de meses de uso, é o maior gargalo. Com as sessões ocultas, fica em aberto como mostrar as tarefas aos usuários; a equipe suspeita que boa parte da interação migre para ferramentas como issues e pull requests do GitHub. Admite ainda que não existe um jeito consolidado de agentes com permissões diferentes colaborarem com segurança.
A segurança leva o alerta mais duro. Um agente ligado a chats e caixas de entrada recebe muito mais conteúdo não confiável do que um que só espera um prompt, e um loop comprometido, por invasão ou por injeção de prompt, poderia expor todos os dispositivos conectados a ele. Qualquer credencial que chegue ao contexto do modelo também pode vazar.
Nossa análise
Na nossa leitura, é um desenho promissor com uma primeira prova modesta. Não há evidência de que agentes sempre ativos superem uma única sessão bem instruída.
Nenhuma das peças é nova, e a equipe não diz que seja. Um despachante na frente de trabalhadores isolados, um filtro rápido antes de um lento, um cache para a memória: são ideias antigas de sistemas, que o ensaio afirma ter tomado emprestadas. A novidade está em aplicá-las aos ambientes bagunçados onde as pessoas realmente trabalham e em manter uma só memória entre todos eles.
Os números dizem menos do que a manchete sugere. Quando a sessão única recebe um prompt para delegar primeiro, a diferença na mediana cai de 8 minutos para cerca de 1,4. O que sobra é sobretudo regularidade: as execuções mais lentas levaram 29 minutos, contra 15,7. E, como o trabalho de programação foi simulado por uma ferramenta que só espera, o teste mede a qualidade do agendamento do sistema, não a qualidade dos resultados.
O custo é o ponto a observar. O Super-agent usou 23,2 milhões de tokens de leitura de cache por execução, cerca do dobro da configuração de delegar primeiro e quase quatro vezes a neutra. Segundo o RuntimeWire, o Harness foi pensado para fluxos longos e com muito uso de cache, e o DeepSeek acabou de reajustar os preços do V4-Pro. Isso é inferência nossa, não algo que o ensaio afirme, mas um agente sempre ativo que mantém várias sessões aquecidas fica caro rapidinho.
Para quem usa agentes hoje, a lição é mais modesta e mais barata: nestes dados, o quanto você deixa claro que o agente deve delegar fez muita diferença. Para agentes sempre ativos, o obstáculo mais difícil provavelmente não é a velocidade, e sim a confiança. Entregar a um agente seus chats, sua caixa de entrada e suas credenciais é uma decisão maior que qualquer benchmark. O que vale acompanhar é se alguém de fora do DeepSeek reproduz esses resultados e se a ideia chega a virar um recurso real do Harness.
Últimas
- 01IPO da Anthropic: retira faixa de US$ 70 a US$ 80 por açãoNegócios · 2026-11-10
- 02Project Zenith no AMD Ryzen AI Halo: Windows 11 para programarProdutos · 2026-11-10
- 03Ação coletiva contra a Nvidia por declarações sobre HuangNegócios · 2026-11-10
- 04Claude Fable 5.2 no GitHub Copilot: política e preçoProdutos · 2026-11-10
- 05Jensen Huang e Megaspeed: a cronologia completa, fato a fatoNegócios · 2026-11-09