DeepSeek Harness propone un agente de IA que nunca se apaga
DeepSeek Harness plantea un agente de IA siempre activo que atienda chat y GitHub a la vez. Es solo una propuesta, con pruebas pequeñas y simuladas.
Puntos clave
- Un Router siempre activo conversa con las personas y varios Workers aislados se encargan de las tareas
- Los eventos de chat, correo y CI llegan como un flujo y filtros baratos los revisan antes de que los vea un modelo
- En la prueba simulada del equipo, el diseño terminó las tareas más rápido que una sola sesión, pero gastó más tokens
- Es una propuesta y un plugin prototipo, no una función lanzada de DeepSeek
- Nadie fuera del equipo ha replicado los resultados
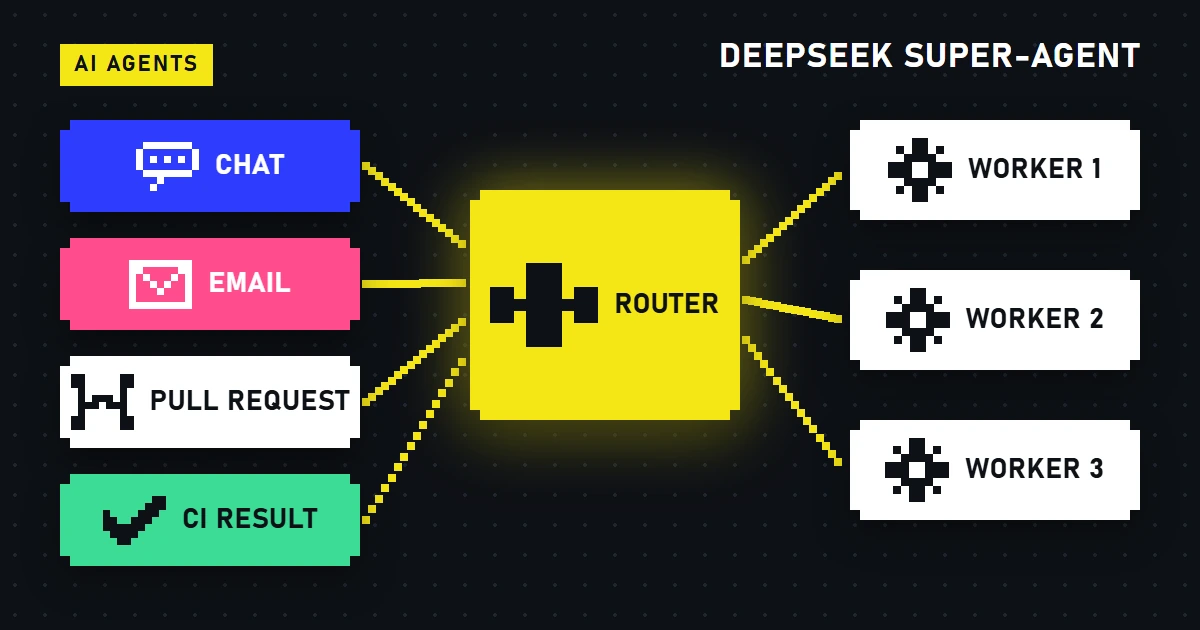
Un agente de IA siempre activo, que atienda por sí solo lo que va llegando a los chats y repositorios de un equipo, es lo que propone DeepSeek Harness. Piensa en un reporte de error que aparece en el chat grupal. Nadie lo responde ni abre un ticket, pero un rato después llega un mensaje: el problema ya está reproducido y hay una solución sencilla. Según el equipo, así trabaja hoy su agente interno, y de ahí nace su nuevo ensayo sobre el diseño del Super-agent.
El ensayo, compartido en X y escrito en chino, plantea un "Super-agent": un agente que nunca se desconecta, sigue chats, correos, comentarios de GitHub y resultados de CI, y mantiene muchas tareas avanzando al mismo tiempo. Harness es el framework de agentes de código abierto de DeepSeek. De acuerdo con el equipo, una versión interna del Super-agent ya le sirve para reproducir errores, responder revisiones de código e incluso construir el propio Harness.
Conviene aclarar algo desde el principio: se trata de una propuesta, no de un lanzamiento. La publicación insiste en que no describe funciones actuales de Harness, y en que dsh-superagent-prototype, el plugin de código abierto que acompaña al ensayo, es un experimento y no un producto oficial de DeepSeek.
La publicación de DeepSeek Harness con el enlace al ensayo de diseño (@DeepSeekHarness)
Un framework joven frente a competidores de peso
Harness acaba de nacer. DeepSeek lanzó la v0.1 el 13 de agosto como un entorno de ejecución de código abierto para crear agentes de programación, junto con la disponibilidad general de su modelo V4-Pro, según informó RuntimeWire con base en VentureBeat. El mismo reporte lo enfrenta a Claude Code, de Anthropic, y a Codex, de OpenAI, y añade que los precios más altos de V4-Pro rigen desde el 16 de agosto. HPCwire lo calificó de versión preliminar para desarrolladores.
Es decir, el equipo ya piensa en el siguiente paso de un framework que lleva apenas unos meses siendo público. Los plugins de Harness, unos 35.000 según DeepSeek, los repasamos en nuestra última nota sobre la comunidad de plugins (en inglés). Y la versión candidata más reciente, que analizamos en lo que cambia por defecto en Harness 0.2.2 (en inglés), muestra que todo sigue en movimiento. La idea también va en la línea de lo que se ve en el sector: en abril, el equipo de ingeniería de Anthropic publicó Scaling Managed Agents, donde describe un harness sin estado separado de los entornos aislados en los que corren las herramientas. Los objetivos difieren, pero la dirección es la misma: sacar el ciclo del agente de una máquina o una sesión en particular.
El cuello de botella eres tú
Los agentes de programación de hoy pueden sostener trabajos largos con poca supervisión. Lo que el equipo cuestiona es todo lo que ocurre alrededor. Por su experiencia, una persona puede seguir entre tres y cinco sesiones de agentes a la vez, y cada una es una isla: uno salta de una a otra tratando de recordar qué estaba haciendo cada cual.
Sumar herramientas de línea de comandos o servidores MCP no lo soluciona, sostiene la publicación. Una sola sesión se congela con las operaciones lentas, mezcla tareas que no tienen relación y se apaga cuando la laptop entra en reposo. Por eso la propuesta saca al agente de la sesión por completo.
Una centralita y varios trabajadores
El diseño tiene dos capas. Arriba está el Router, una sesión de larga duración que atiende todas las conversaciones con personas. No hace el trabajo: es algo así como una centralita con memoria, y según el ensayo, para correrlo suele bastar un modelo más liviano y barato. Debajo están los Workers, que se encargan de las tareas reales, cada uno en su propia sesión aislada, con todas las herramientas y el modelo más potente disponible. Nunca hablan con las personas: reportan al Router, y es el Router quien redacta cada respuesta.
Esto se distingue del patrón de "equipo de agentes", en el que un agente líder divide una tarea grande en subtareas estrechamente ligadas. Aquí el Router solo reparte trabajos independientes y lleva el registro de cómo se relacionan. En el despliegue propio del equipo, el Router es una única sesión de LLM que permanece activa.
No todos los mensajes merecen un modelo
El agente no espera instrucciones. Vigila un flujo de eventos: mensajes de chats grupales, correos, recordatorios de calendario, comentarios de revisión y resultados de CI. Como los chats y las plataformas de código generan mucho ruido, primero pasa un código convencional que hace un filtrado barato, y solo los candidatos probables llegan a un modelo de lenguaje, que aplica reglas escritas en lenguaje natural y que cualquiera puede reescribir cuando quiera.
Cuando un Worker se hace cargo de un hilo, por ejemplo un pull request, los eventos posteriores de ese hilo le llegan directo, sin pasar de nuevo por el Router. Para que el contexto no se hinche, el sistema trata la memoria del modelo como un caché: mantiene a mano los detalles que probablemente harán falta y guarda referencias que permiten rastrear tareas anteriores. El equipo lo llama Chain of Recall.
Hay dos decisiones más pequeñas que llaman la atención. Las llamadas largas a herramientas corren en segundo plano y devuelven "Started" de inmediato, así que el agente sigue respondiendo mientras el trabajo avanza (según el equipo, Harness ya lo admite, pero viene desactivado por defecto). Además, el ciclo del agente corre en contenedores en la nube sin estado, mientras que los repositorios y las credenciales se quedan en el equipo del usuario.
Más rápido, pero a costa de tokens
Las cifras de la prueba llevan un asterisco enorme, que el propio equipo pone al frente: cargas de trabajo sintéticas, configuraciones simplificadas y cinco ejecuciones por diseño. Cada diseño procesó unos 300 mensajes de chat grupal y de CI de GitHub, de los cuales unos 20 eran solicitudes reales, y el trabajo de programación se simuló con una herramienta que solo consume tiempo.
En esa prueba, la tarea mediana del Super-agent tardó 12,4 minutos, y los casos más lentos llegaron a 15,7. Una sola sesión con una herramienta de subagente demoró 20,4 minutos (29,5 en los casos más lentos) con una instrucción neutral, y 13,8 (29,0) cuando se le indicó delegar primero. Con la instrucción neutral, el modelo no delegó en ninguna de las cinco ejecuciones. Con la de delegar lo hizo en cuatro; en la quinta consideró que el trabajo era pequeño y lo resolvió él mismo, lo que alargó los casos más lentos.
La rapidez tiene su precio. El Super-agent consumió 23,2 millones de tokens de lectura de caché por ejecución, frente a 6,1 y 10,8 millones en las configuraciones de una sola sesión. Al desactivar el traspaso directo a los Workers, los tiempos de finalización no cambiaron, pero las decisiones del Router subieron cerca de un 30 % y los tokens, aproximadamente un 37 %, hasta 31,8 millones. En una prueba de estrés aparte, con Workers simulados, el tiempo por solicitud pasó de apenas 2,5 a 3,9 segundos mientras los eventos que exigían una decisión subían de alrededor de 1 a alrededor de 40 por minuto. De ahí el equipo concluye que, con su tamaño actual, una sola sesión de Router es suficiente.
Dónde podría fallar
La publicación es franca sobre lo que aún no resuelve. Nadie sabe todavía cuándo conviene dividir el Router ni en qué momento los Workers deberían comunicarse entre sí. La memoria de largo plazo, tras meses de uso, es el mayor cuello de botella. Cómo mostrar las tareas a los usuarios cuando las sesiones quedan ocultas es una pregunta abierta, y el equipo sospecha que buena parte de la interacción pasará a herramientas como los issues y los pull requests de GitHub. También admite que no existe una forma consolidada de que agentes con permisos distintos colaboren con seguridad.
La seguridad es el punto que más advertencias recibe. Un agente conectado a chats y bandejas de entrada ve mucho más contenido no confiable que uno que espera instrucciones, y un ciclo comprometido, ya sea por una intrusión o por inyección de prompts, podría dejar expuestos todos los dispositivos a los que está conectado. Cualquier credencial que pueda llegar al contexto del modelo también puede filtrarse.
Nuestro análisis
Nuestra lectura: es un diseño prometedor, pero con una primera prueba modesta. No demuestra que los agentes siempre activos superen a una sola sesión bien instruida.
Ninguna de las piezas es nueva, y el equipo tampoco lo afirma. Un despachador frente a trabajadores aislados, un filtro rápido antes de uno lento, un caché para la memoria: son ideas clásicas de sistemas que, según el ensayo, se tomaron prestadas. Lo novedoso es aplicarlas a los lugares desordenados donde la gente realmente trabaja y conservar una sola memoria entre todos ellos.
Las cifras dicen menos de lo que sugiere el titular. Si a la configuración de una sola sesión se le da la instrucción de delegar primero, la diferencia en la mediana baja de 8 minutos a cerca de 1,4. Lo que queda es sobre todo constancia: las ejecuciones más lentas tardaron 29 minutos, frente a 15,7. Y como el trabajo de programación se simuló con una herramienta que solo espera, la prueba mide qué tan bien programa tareas el sistema, no qué tan buenos son los resultados.
Lo que habría que vigilar es el costo. El Super-agent usó 23,2 millones de tokens de lectura de caché por ejecución: más o menos el doble que la configuración de delegar primero y casi cuatro veces la neutral. Según RuntimeWire, Harness está pensado para flujos largos y con mucho caché, y DeepSeek acaba de subir los precios de V4-Pro. Es una inferencia nuestra, no algo que diga el ensayo, pero un agente siempre activo que mantiene varias sesiones abiertas se encarece rápidamente.
Para quien hoy trabaja con agentes, la lección es más modesta y barata: en estos datos, qué tan claro se le pide a un agente que delegue pesó mucho. En los agentes siempre activos, el obstáculo más difícil probablemente no sea la velocidad, sino la confianza. Ceder a un agente tus chats, tu bandeja de entrada y tus credenciales es una decisión mayor que cualquier benchmark. Habrá que ver si alguien fuera de DeepSeek reproduce estos resultados y si la idea llega algún día a ser una función real de Harness.
Fuente: Equipo de DeepSeek Harness en X
Últimas
- 01OPI de Anthropic: retira el rango de $70 a $80 por acciónNegocios · 2026-11-10
- 02Project Zenith en AMD Ryzen AI Halo: Windows 11 para programarProductos · 2026-11-10
- 03Demanda colectiva contra Nvidia por las declaraciones sobre HuangNegocios · 2026-11-10
- 04Claude Fable 5.2 en GitHub Copilot: política y precioProductos · 2026-11-10
- 05Jensen Huang y Megaspeed: la cronología completa, dato por datoNegocios · 2026-11-09