Claude Fable 5.2 e Mythos 5.2: US$ 8 por milhão de tokens
Claude Fable 5.2 custa US$ 8 por milhão de tokens, 20% menos que o 5.1. Onde os benchmarks da Anthropic lideram, onde o Opus 5.5 vence e o que o Mythos traz.
Pontos principais
- A Anthropic lançou o Claude Fable 5.2 e o Claude Mythos 5.2 em 9 de novembro de 2026; são o mesmo modelo de base, e só o Fable está aberto a todos
- O Fable 5.2 custa US$ 8 por milhão de tokens de entrada e US$ 40 por milhão de saída, contra US$ 10 e US$ 50 do Fable 5.1 (20% a menos, pelas nossas contas)
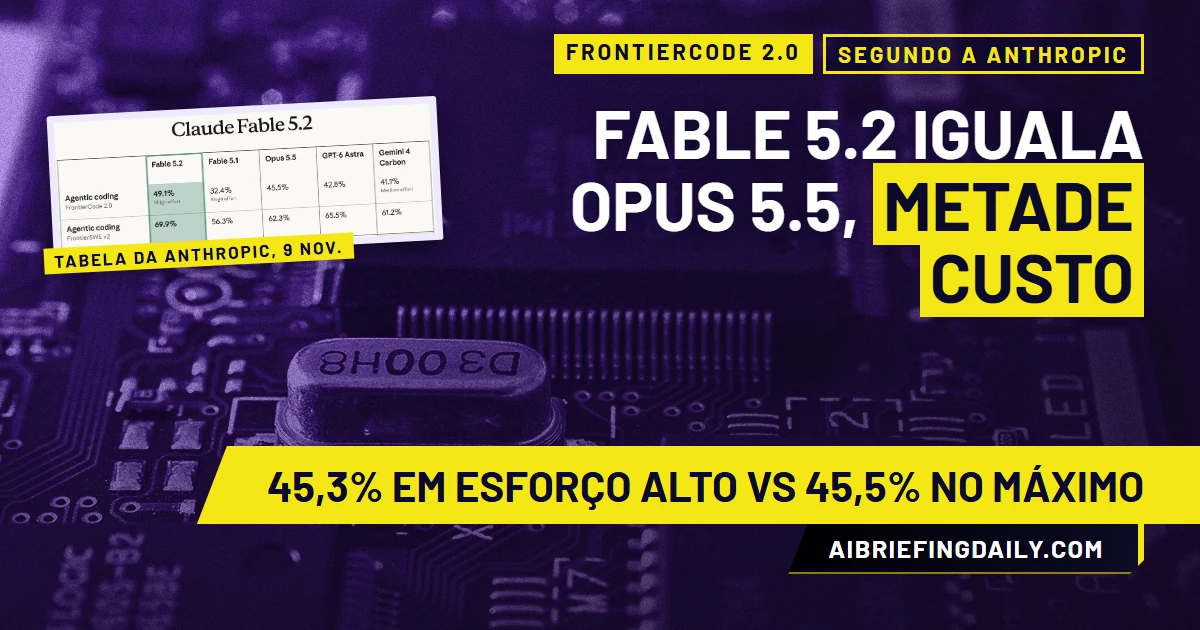
- No FrontierCode 2.0, o Fable 5.2 em esforço alto marca 45,3%, contra 45,5% do melhor resultado do Opus 5.5, com cerca de metade do custo por tarefa
- O Opus 5.5 segue na frente no Elo do AA-Briefcase, e o Gemini 4 Carbon lidera o AutomationBench
- Quase todos os números vêm da tabela da própria Anthropic, e a linha de cibersegurança entre laboratórios compara conjuntos de tarefas diferentes
O Fable 5.1 custava US$ 10 por milhão de tokens de entrada. O Fable 5.2 custa US$ 8. Na segunda-feira, 9 de novembro de 2026, a Anthropic lançou o Claude Fable 5.2 e o Claude Mythos 5.2, e o preço menor vem junto com o que a empresa descreve como seus modelos mais fortes para "desafios técnicos assustadores".
Publicação de lançamento do Claude no X, 9 de novembro de 2026, com o vídeo de apresentação de 18 segundos (@claudeai)
A primeira publicação da conversa do @claudeai diz que os modelos melhoram em programação, raciocínio e visão. As respostas citam três grupos externos que os testaram antes do lançamento (o UK AI Security Institute, a Frontier Design e a METR) e afirmam que os modelos geram saída até 30% mais rápido que o Fable 5.1 e o Mythos 5.1. A tabela de benchmarks está na terceira resposta. Lemos o anúncio completo e a página do produto Fable.
Fable e Mythos são um só modelo com dois conjuntos de proteções. O Fable 5.2 traz salvaguardas de cibersegurança e biologia e está aberto a todos os usuários; o Mythos 5.2 vai para organizações aprovadas pelos Programas de Verificação em Cibersegurança e em Ciências da Vida da Anthropic. Para a maior parte do trabalho de programação e de conhecimento, a Anthropic continua recomendando o Claude Opus 5.5 como modelo do dia a dia.
Quanto custa, onde roda e a promoção de lançamento
O nome na API é claude-fable-5-2. O anúncio diz que ele está disponível "em todas as plataformas, incluindo Amazon Web Services, Google Cloud e Microsoft Azure". A página do produto cita Amazon Web Services, Google Cloud e Microsoft Foundry. Não vimos o Amazon Bedrock citado em nenhuma das duas páginas, então confira o console da sua nuvem antes de montar um plano em cima dele.
O preço padrão é US$ 8 por milhão de tokens de entrada e US$ 40 por milhão de saída, "abaixo de US$ 10 e US$ 50 do Fable 5.1", segundo a página do produto. É 20% de desconto nos dois lados (conta nossa: 8 ÷ 10 e 40 ÷ 50), e a CNBC informa o mesmo percentual. O modo rápido, até 2,5 vezes mais veloz, custa US$ 16 e US$ 80, o dobro da tarifa padrão. Nos aplicativos do Claude, os planos elegíveis recebem de um a três "resets do Fable" nesta semana, e o esforço médio é o padrão tanto lá quanto no Claude Code.
A tabela de resultados, com as notas de rodapé
A tabela da Anthropic compara o Fable 5.2 com o Fable 5.1, o Opus 5.5, o GPT-6 Astra da OpenAI e o Gemini 4 Carbon do Google. Estas são as linhas mais limpas, como foram publicadas:
- FrontierCode 2.0 (Fable em Xhigh): Fable 5.2 49,1%; Fable 5.1 32,4%; Opus 5.5 45,5%; GPT-6 Astra 42,8%; Gemini 4 Carbon 41,1%
- FrontierSWE v2: Fable 5.2 69,9%; Fable 5.1 56,3%; Opus 5.5 62,3%; GPT-6 Astra 65,5%; Gemini 4 Carbon 61,2%
- AutomationBench: Fable 5.2 51,4%; Fable 5.1 31,4%; Opus 5.5 42,5%; GPT-6 Astra 41,4%; Gemini 4 Carbon 53,9%
- OSWorld 2.1 (offline, parcial): Fable 5.2 89,3%; Fable 5.1 83,5%; Opus 5.5 87,2%; GPT-6 Astra 79,5%; Gemini 4 Carbon 81,5%
- Remote Labor Index (High): Fable 5.2 41,3%; Fable 5.1 17,9%; Opus 5.5 21,3%; GPT-6 Astra 20,8%
- Humanity's Last Exam, com ferramentas: Fable 5.2 74,2%; Fable 5.1 65,6%; Opus 5.5 67,7%; GPT-6 Astra 57,2%
- RoboDojo Sim (execução interna): Fable 5.2 64,9%; Fable 5.1 27,6%; Opus 5.5 39,4%; GPT-6 Astra 29,8%
Pelas nossas contas: no FrontierCode 2.0, o modelo novo fica 16,7 pontos acima do Fable 5.1 e 3,6 acima do Opus 5.5. No Remote Labor Index, 41,3 contra 21,3 do Opus 5.5 dá cerca de 1,9 vez. No RoboDojo, que testa o controle de um robô simulado de dois braços a partir de imagens de câmera, 64,9% é cerca de 2,2 vezes os 29,8% do GPT-6 Astra.
Essa última diferença pede cautela, com base na nossa própria cobertura. No artigo do uni-robot-agent, o GPT-6 Astra marcou 28,97 em uma estrutura de testes e 51,90 em outra, ou seja, o arcabouço em torno de um modelo de robô pode mudar a nota em mais de 20 pontos. A Anthropic diz que rodou os concorrentes na mesma estrutura e rotula a linha como execução interna. Isso vale dentro do ambiente da Anthropic, mas não é um ranking definitivo.
Metade do custo, se você escolher o nível certo
A promessa prática é sobre custo, e a quarta publicação da conversa a traz.
Claude no X, 9 de novembro de 2026: a afirmação de custo por tarefa no FrontierCode 2.0 e o esforço padrão (@claudeai)
O Fable 5.2 em esforço alto ficou praticamente empatado com o Opus 5.5 em esforço máximo no FrontierCode 2.0 "por cerca de metade do custo por tarefa", diz a publicação, e em Xhigh marcou o maior resultado entre todos os modelos lançados que a Anthropic testou. O anúncio traz os números: 45,3% contra 45,5%, com o melhor resultado do GPT-6 Astra em 42,8%. O FrontierCode mede se as alterações de código de um modelo seriam aceitas pelos mantenedores de repositórios de código aberto.
Afirmações parecidas vêm em seguida. No teste de busca agêntica WANDR, da Perplexity, o esforço médio iguala a melhor nota do Opus 5.5 por cerca de 40% do custo. No Humanity's Last Exam, o esforço baixo a iguala por menos de um décimo do custo.
Nossa leitura: a notícia não é que o Fable 5.2 vença em tudo. Um modelo com preço por token duas vezes maior que o do Opus 5.5 (o OfficeChai lista o Opus 5.5 a US$ 4 e US$ 20, valor que não conseguimos confirmar nas páginas da Anthropic) ainda pode terminar uma tarefa por menos dinheiro se precisar de menos tokens num ajuste mais baixo. Essas curvas de custo vêm de "testes iniciais" da própria Anthropic, então o número em que confiar é o que você mesmo medir.
Onde o Fable 5.2 não lidera
Os 53,9% do Gemini 4 Carbon no AutomationBench superam os 51,4% do Fable 5.2. No teste de trabalho de conhecimento AA-Briefcase, o Fable 5.2 lidera na rubrica (66,1% contra 61,2% do Opus 5.5), mas o Opus 5.5 tem o Elo mais alto, 1800 a 1785. No Chartography, os 73,4% do Fable 5.2 no esforço máximo superam por pouco os 72,5% do Gemini, mas no ajuste médio que a Anthropic destaca (66,4%), tanto o GPT-6 Astra (71,0%) quanto o Gemini estão à frente.
Nas palavras da própria Anthropic, os modelos são "um passo acima do Opus 5.5 em quase todas as capacidades que avaliamos". O "quase" pesa.
Atualização, 9 de novembro de 2026: a Meta também lançou hoje um modelo pequeno, o Muse Ember, e o compara com o Claude Haiku 5.5 em custo por tarefa; nossa análise do preço e dos benchmarks do Muse Ember contra o Claude Haiku 5.5 mostra o Haiku à frente no FrontierCode 2.0-AA, 34,9% a 27,2%.
Mythos 5.2 e as linhas de cibersegurança
A Anthropic chama o Mythos 5.2 de seu modelo mais capaz em engenharia de cibersegurança. No CVE Rediscovery, um teste interno que entrega ao modelo uma cópia do projeto de antes da correção de uma vulnerabilidade conhecida, ele marca 89,6%, contra 81,3% do Opus 5.5 sem salvaguardas e 78,3% do Mythos 5.1. A Anthropic traduz isso como 10,2% mais vulnerabilidades que o Opus 5.5 e 14,4% mais que o Mythos 5.1, o que bate com a nossa divisão da tabela (89,6 ÷ 81,3 e 89,6 ÷ 78,3). A execução de outubro de 2026 cobriu 1.829 CVEs. Brian Grinstead, da Mozilla, diz que o Mythos 5.2 "praticamente dobrou as métricas de descoberta de vulnerabilidades do Mythos 5.1" nas campanhas de varredura da empresa.
A linha para ler devagar é o CyScenarioBench: Mythos 5.2 com 76,3%, "GPT-6 Cyber" com 61%. Uma nota de rodapé diz que as notas de cada laboratório usam "tarefas únicas", ou seja, esses percentuais vêm de problemas diferentes. Cobrimos o lado da OpenAI em nossa reportagem sobre os números do GPT-6 Cyber no Firefox e no Linux, em que todos os números também vinham do fornecedor. Outra nota de rodapé aponta no sentido contrário: nas avaliações da própria Anthropic, a identificação de vulnerabilidades está "praticamente no mesmo nível do Opus 5.5".
Os classificadores do Fable 5.2 ainda bloqueiam a maioria das tarefas de teste de intrusão e de geração de exploits e a maior parte da pesquisa em biologia, e as consultas bloqueadas são respondidas pelo Opus 4.8 (cibersegurança) ou pelo Opus 5 (biologia). A Anthropic informa cerca de 55% menos bloqueios que o Fable 5.1.
Uma equipe de 1.000 agentes do Fable 5.2 formalizou a prova do Último Teorema de Fermat na linguagem Lean em 30 horas. A primeira formalização da Anthropic levou 11 dias, então o ganho é de cerca de 8,8 vezes (conta nossa: 264 horas ÷ 30). Com a mesma configuração, o Opus 5.5 chegou a 26% depois de 18 horas. A Anthropic também descreve um protótipo de sistema operacional criado por mais de 1.000 subagentes em oito dias, uma migração de serviço de Python para Rust que "começa cerca de 26 vezes mais rápido" e três dispositivos eletrônicos funcionais construídos com a fabricante de placas de circuito Diode. São relatos da Anthropic, e não lemos os preprints vinculados.
O que a Anthropic diz sobre segurança, e o que admite
A Anthropic diz acreditar que "os riscos de alto impacto de desalinhamento continuam baixos". Na auditoria comportamental de cerca de 1.900 cenários, o Mythos 5.2 marcou 2,67 (quanto menor, melhor), contra 2,79 do Opus 5.5 e 3,28 do Mythos 5.1. Num teste de fuga de ambiente isolado com mais de 1.800 cenários, ele usou credenciais ou arquivos plantados em 3,1% deles, no mesmo patamar do Opus 5.5 (3,3%) e bem abaixo do Mythos 5 e do 5.1 (39% e 21%).
A ressalva é da própria Anthropic: os dois modelos dizem suspeitar que estão sendo avaliados "com mais frequência do que qualquer um dos nossos modelos recentes", o que turva a previsão de como agiriam no uso real. Uma nota de rodapé acrescenta que o UK AI Security Institute, a Frontier Design e a METR não revisaram a publicação nem o system card. Não conseguimos abrir o PDF do system card, então seus detalhes, inclusive qualquer classificação de nível de risco, não foram verificados por nós.
A Anthropic também diz que limitou os ganhos em P&D de IA durante o treinamento, de modo que as habilidades de otimização de kernel e de arquitetura de LLMs ficam em torno do nível do Opus 5.5. Para entender por que essa linha existe, veja o relatório da METR sobre a aceleração do P&D de IA na Anthropic.
A CNBC informa que é o primeiro lançamento de fronteira da Anthropic desde que Dario Amodei defendeu desacelerar o desenvolvimento de IA, e cita Dianne Penn, chefe de gestão de produto para pesquisa: "Pedimos ritmo, não pausa." A mesma reportagem diz que um IPO pode sair já na semana que vem, com valor-alvo de US$ 1 trilhão a US$ 1,5 trilhão, abaixo dos US$ 2 trilhões cogitados. Os números por trás dessa oferta, incluindo os US$ 895,4 bilhões em compromissos de computação, estão em nossa análise do S-1 revisado da Anthropic, publicada em inglês. ## Teste uma tarefa difícil em esforço alto
Na API, pegue uma tarefa difícil que você já roda no Opus 5.5 na configuração máxima, rode-a no claude-fable-5-2 em esforço alto e compare resultados aceitos por dólar, não pontos de benchmark. Nos aplicativos, lembre que o esforço médio é o padrão, e que os melhores números da Anthropic vieram de esforço alto, Xhigh ou máximo.
A dúvida em aberto é a replicação: a Anthropic não disse quem executou a nota de 49,1% no FrontierCode além da sua própria tabela.
Atualização, 9 de novembro de 2026: o GitHub tornou o Fable 5.2 disponível de forma geral no Copilot, onde os administradores de Business e Enterprise precisam ativar uma política que aceita a retenção de dados da Anthropic; nossa matéria sobre o Claude Fable 5.2 no GitHub Copilot, a política de administrador e o preço no Copilot traz as tarifas e o prazo de fim de ano para a retenção zero.
Fonte: Anthropic, Introducing Claude Fable 5.2 and Claude Mythos 5.2
Últimas
- 01IPO da Anthropic: retira faixa de US$ 70 a US$ 80 por açãoNegócios · 2026-11-10
- 02Project Zenith no AMD Ryzen AI Halo: Windows 11 para programarProdutos · 2026-11-10
- 03Ação coletiva contra a Nvidia por declarações sobre HuangNegócios · 2026-11-10
- 04Claude Fable 5.2 no GitHub Copilot: política e preçoProdutos · 2026-11-10
- 05Jensen Huang e Megaspeed: a cronologia completa, fato a fatoNegócios · 2026-11-09