Claude Fable 5.2 baja a $8 por millón de tokens
Claude Fable 5.2 cuesta $8 por millón de tokens de entrada, 20% menos que 5.1. Dónde lidera en benchmarks, dónde gana Opus 5.5 y qué suma Mythos 5.2.
Puntos clave
- Anthropic lanzó Claude Fable 5.2 y Claude Mythos 5.2 el 9 de noviembre de 2026; son el mismo modelo de base y solo Fable está abierto a todos
- Fable 5.2 cuesta $8 por millón de tokens de entrada y $40 por millón de salida, frente a $10 y $50 de Fable 5.1 (20% menos según nuestras cuentas)
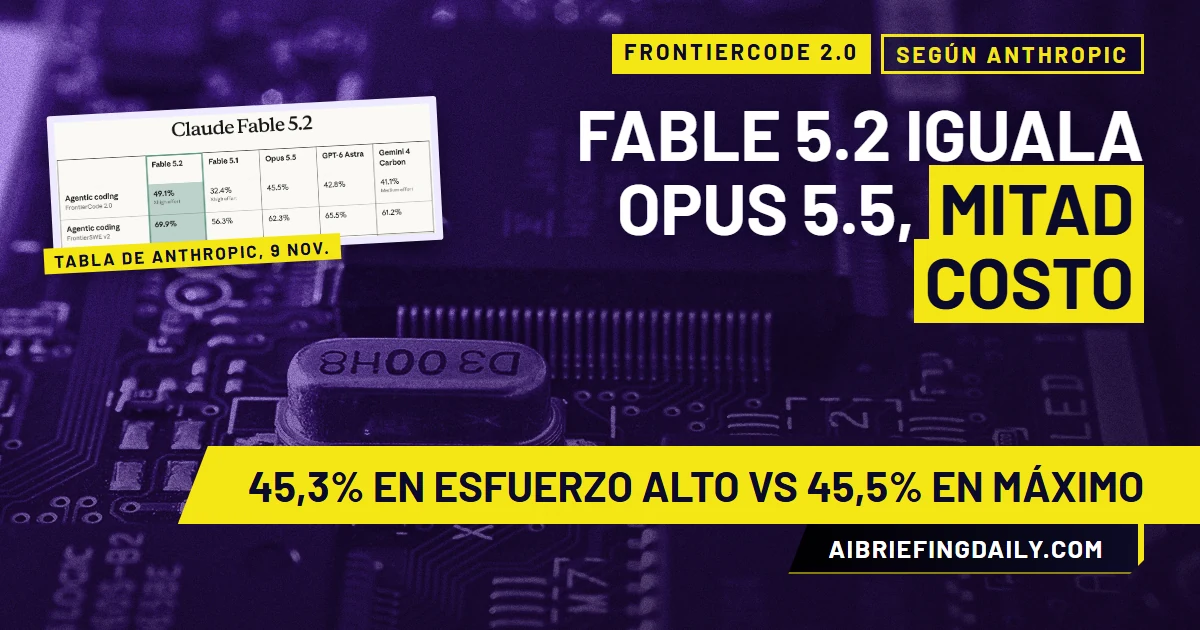
- En FrontierCode 2.0, Fable 5.2 con esfuerzo alto logra 45,3% frente al mejor 45,5% de Opus 5.5, con cerca de la mitad del costo por tarea
- Opus 5.5 sigue arriba en el puntaje Elo de AA-Briefcase y Gemini 4 Carbon lidera en AutomationBench
- Casi todas las cifras salen de la tabla de Anthropic, y su fila de ciberseguridad entre laboratorios compara conjuntos de tareas distintos
Fable 5.1 costaba $10 por millón de tokens de entrada. Fable 5.2 cuesta $8. El lunes 9 de noviembre de 2026, Anthropic lanzó Claude Fable 5.2 y Claude Mythos 5.2, y la rebaja llega junto a lo que la empresa presenta como sus modelos más fuertes para "desafíos técnicos abrumadores".
Publicación de lanzamiento de Claude en X del 9 de noviembre de 2026, con el video de anuncio de 18 segundos (@claudeai)
La primera publicación del hilo de @claudeai dice que los modelos mejoran en programación, razonamiento y visión. En las respuestas se nombran tres grupos externos que los probaron antes del lanzamiento (el Instituto de Seguridad de IA del Reino Unido, Frontier Design y METR) y se afirma que generan resultados hasta 30% más rápido que Fable 5.1 y Mythos 5.1. La tabla de benchmarks está en la tercera respuesta. Leímos el anuncio completo y la página del producto Fable.
Fable y Mythos son un mismo modelo con dos conjuntos de salvaguardas. Fable 5.2 incluye protecciones de ciberseguridad y biología y está abierto a todos los usuarios; Mythos 5.2 se entrega a organizaciones aprobadas mediante los Programas de Verificación de Ciberseguridad y de Ciencias de la Vida de Anthropic. Para la mayoría de las tareas de programación y trabajo del conocimiento, Anthropic sigue recomendando Claude Opus 5.5 como modelo de uso diario.
Cuánto cuesta, dónde se usa y la promoción de estreno
El nombre en la API es claude-fable-5-2. El anuncio dice que está disponible "en todas las plataformas, incluidas Amazon Web Services, Google Cloud y Microsoft Azure" (traducción de la cita). La página del producto nombra Amazon Web Services, Google Cloud y Microsoft Foundry. No vimos Amazon Bedrock mencionado en ninguna de las dos páginas, así que conviene revisar tu consola de nube antes de armar planes con él.
La tarifa estándar es de $8 por millón de tokens de entrada y $40 por millón de salida, "frente a $10 y $50 de Fable 5.1", según la página del producto (traducción de la cita). Es 20% menos en ambos lados (cuenta nuestra: 8 ÷ 10 y 40 ÷ 50), y CNBC informa la misma cifra. El modo rápido, hasta 2,5 veces más veloz, cuesta $16 y $80, el doble de la tarifa estándar. En las apps de Claude, los planes elegibles reciben de uno a tres "reinicios de Fable" esta semana, y el esfuerzo medio es el valor por defecto tanto ahí como en Claude Code.
Los benchmarks, con sus notas al pie
La tabla de Anthropic enfrenta a Fable 5.2 con Fable 5.1, Opus 5.5, GPT-6 Astra de OpenAI y Gemini 4 Carbon de Google. Estas son las filas más limpias, tal como se publicaron:
- FrontierCode 2.0 (Fable en Xhigh): Fable 5.2 49,1%; Fable 5.1 32,4%; Opus 5.5 45,5%; GPT-6 Astra 42,8%; Gemini 4 Carbon 41,1%
- FrontierSWE v2: Fable 5.2 69,9%; Fable 5.1 56,3%; Opus 5.5 62,3%; GPT-6 Astra 65,5%; Gemini 4 Carbon 61,2%
- AutomationBench: Fable 5.2 51,4%; Fable 5.1 31,4%; Opus 5.5 42,5%; GPT-6 Astra 41,4%; Gemini 4 Carbon 53,9%
- OSWorld 2.1 (sin conexión, parcial): Fable 5.2 89,3%; Fable 5.1 83,5%; Opus 5.5 87,2%; GPT-6 Astra 79,5%; Gemini 4 Carbon 81,5%
- Remote Labor Index (High): Fable 5.2 41,3%; Fable 5.1 17,9%; Opus 5.5 21,3%; GPT-6 Astra 20,8%
- Humanity's Last Exam, con herramientas: Fable 5.2 74,2%; Fable 5.1 65,6%; Opus 5.5 67,7%; GPT-6 Astra 57,2%
- RoboDojo Sim (prueba interna): Fable 5.2 64,9%; Fable 5.1 27,6%; Opus 5.5 39,4%; GPT-6 Astra 29,8%
Según nuestras cuentas, en FrontierCode 2.0 el modelo nuevo queda 16,7 puntos sobre Fable 5.1 y 3,6 sobre Opus 5.5. En Remote Labor Index, 41,3 frente a los 21,3 de Opus 5.5 es cerca de 1,9 veces. En RoboDojo, que mide el control de un robot simulado de dos brazos a partir de imágenes de cámara, 64,9% equivale a unas 2,2 veces los 29,8% de GPT-6 Astra.
Sobre esa última brecha hay que ser cuidadosos, y lo sabemos por nuestra propia cobertura. En el estudio del agente uni-robot, GPT-6 Astra sacó 28,97 con un arnés de pruebas y 51,90 con otro, de modo que el andamiaje alrededor de un modelo de robots puede mover un puntaje más de 20 puntos. Anthropic dice que ejecutó a sus rivales con el mismo arnés y marca la fila como prueba interna. Eso es razonable dentro del montaje de Anthropic, pero no es un ranking definitivo.
La mitad del costo, si eliges bien el nivel de esfuerzo
La afirmación práctica gira en torno al costo, y la cuarta publicación del hilo la desarrolla.
Claude en X, 9 de noviembre de 2026: el dato de costo por tarea en FrontierCode 2.0 y el esfuerzo por defecto (@claudeai)
Fable 5.2 con esfuerzo alto quedó casi igual que Opus 5.5 con esfuerzo máximo en FrontierCode 2.0 "por aproximadamente la mitad del costo por tarea", dice la publicación, y con esfuerzo Xhigh obtuvo el puntaje más alto de todos los modelos publicados que Anthropic ha probado. El anuncio da las cifras: 45,3% contra 45,5%, con el mejor resultado de GPT-6 Astra en 42,8%. FrontierCode mide si los cambios de código de un modelo serían aceptados por los responsables de repositorios de código abierto.
Siguen afirmaciones parecidas. En la prueba de búsqueda con agentes WANDR de Perplexity, el esfuerzo medio iguala el mejor puntaje de Opus 5.5 por cerca de 40% del costo. En Humanity's Last Exam, el esfuerzo bajo lo iguala por menos de una décima parte del costo.
Nuestra lectura: lo importante no es que Fable 5.2 gane en todas las pruebas. Un modelo con una tarifa por token del doble que Opus 5.5 (OfficeChai lista a Opus 5.5 en $4 y $20, una cifra que no pudimos confirmar en las páginas de Anthropic) aún puede terminar una tarea por menos dinero si necesita menos tokens en un nivel más bajo. Esas curvas de costo salen de "pruebas tempranas" de Anthropic, así que la cifra confiable es la que midas tú.
En qué pruebas Fable 5.2 no lidera
El 53,9% de Gemini 4 Carbon en AutomationBench supera el 51,4% de Fable 5.2. En AA-Briefcase, la prueba de trabajo del conocimiento, Fable 5.2 gana en la rúbrica (66,1% frente a 61,2% de Opus 5.5), pero Opus 5.5 conserva el Elo más alto: 1800 contra 1785. En Chartography, los 73,4% de Fable 5.2 con el máximo esfuerzo superan por poco los 72,5% de Gemini, aunque en el nivel medio que destaca Anthropic (66,4%) tanto GPT-6 Astra (71,0%) como Gemini van por delante.
Anthropic lo resume así: los modelos están "un escalón por encima de Opus 5.5 en casi todas las capacidades que evaluamos" (traducción de la cita). Ese "casi" pesa.
Actualización, 9 de noviembre de 2026: Meta también lanzó hoy un modelo pequeño, Muse Ember, y lo compara con Claude Haiku 5.5 en costo por tarea; nuestro análisis de el precio y los benchmarks de Muse Ember frente a Claude Haiku 5.5 muestra a Haiku por delante en FrontierCode 2.0-AA, 34.9% a 27.2%.
Mythos 5.2 y las filas de ciberseguridad
Anthropic presenta a Mythos 5.2 como su modelo más capaz en ingeniería de ciberseguridad. En CVE Rediscovery, una prueba interna que le da al modelo una copia de un proyecto de antes de que se corrigiera una vulnerabilidad conocida, alcanza 89,6%, frente a 81,3% de Opus 5.5 sin salvaguardas y 78,3% de Mythos 5.1. Anthropic lo expresa como 10,2% más vulnerabilidades que Opus 5.5 y 14,4% más que Mythos 5.1, lo que coincide con nuestra división de la tabla (89,6 ÷ 81,3 y 89,6 ÷ 78,3). La ejecución de octubre de 2026 abarcó 1.829 CVE. Brian Grinstead, de Mozilla, afirma que Mythos 5.2 "prácticamente duplicó las métricas de descubrimiento de vulnerabilidades de Mythos 5.1" en sus campañas de escaneo (traducción de la cita).
La fila que conviene leer con calma es CyScenarioBench: Mythos 5.2 con 76,3% y "GPT-6 Cyber" con 61%. Una nota al pie aclara que los puntajes de cada laboratorio usan "tareas únicas", así que esos porcentajes salen de problemas distintos. Cubrimos la parte de OpenAI en nuestra nota sobre las cifras de GPT-6 Cyber en Firefox y Linux, donde todas las cifras también venían del propio proveedor. Otra nota al pie juega en sentido contrario: en las evaluaciones propias de Anthropic, dice, la identificación de vulnerabilidades queda "aproximadamente a la par de Opus 5.5".
Los clasificadores de Fable 5.2 siguen bloqueando la mayoría de las tareas de pruebas de penetración y generación de exploits, y la mayor parte de la investigación en biología; las consultas bloqueadas las responde Opus 4.8 (ciberseguridad) u Opus 5 (biología). Anthropic reporta cerca de 55% menos bloqueos que con Fable 5.1.
El teorema de Fermat y otras tareas largas
Un equipo de 1.000 agentes de Fable 5.2 formalizó la demostración del último teorema de Fermat en el lenguaje Lean en 30 horas. La primera formalización de Anthropic tardó 11 días, así que esto es unas 8,8 veces más rápido (cuenta nuestra: 264 horas ÷ 30). Con la misma configuración, Opus 5.5 llegó a 26% tras 18 horas. Anthropic describe además un sistema operativo prototipo construido por más de 1.000 subagentes en ocho días, la migración de un servicio de Python a Rust que "arranca unas 26 veces más rápido" y tres dispositivos electrónicos funcionales creados con Diode, fabricante de placas de circuitos. Son relatos de Anthropic y no hemos leído los preprints enlazados.
Seguridad: lo que Anthropic afirma y lo que admite
Anthropic dice creer que "los riesgos de alto impacto por desalineación siguen siendo bajos" (traducción de la cita). En su auditoría de comportamiento de unos 1.900 escenarios, Mythos 5.2 obtuvo 2,67 (menor es mejor), frente a 2,79 de Opus 5.5 y 3,28 de Mythos 5.1. En una prueba de escape de entorno aislado con más de 1.800 escenarios, usó credenciales o archivos plantados en 3,1% de ellos, a la par de Opus 5.5 (3,3%) y muy por debajo de Mythos 5 y 5.1 (39% y 21%).
La advertencia es de la propia Anthropic: ambos modelos dicen sospechar que los están evaluando "con más frecuencia que cualquiera de nuestros modelos recientes" (traducción de la cita), lo que enturbia cómo actuarían en un uso real. Una nota al pie añade que el Instituto de Seguridad de IA del Reino Unido, Frontier Design y METR no revisaron la publicación ni la ficha del sistema. No pudimos abrir el PDF de la ficha del sistema, así que sus detalles, incluida cualquier clasificación de nivel de riesgo, quedan sin verificar aquí.
Anthropic también dice que limitó los avances en investigación y desarrollo de IA durante el entrenamiento, por lo que las habilidades de optimización de kernels y de arquitectura de LLM quedan cerca del nivel de Opus 5.5. Para entender por qué existe esa línea, revisa el informe de METR sobre la aceleración de I+D de IA en Anthropic.
La salida a bolsa que corre detrás del lanzamiento
CNBC informa que es el primer lanzamiento de frontera de Anthropic desde que Dario Amodei pidió frenar el desarrollo de la IA, y cita a Dianne Penn, jefa de gestión de producto para investigación: "Pedimos ir con ritmo, no detenernos" (traducción de la cita). La misma nota dice que una salida a bolsa podría llegar tan pronto como la próxima semana, con una valoración objetivo de entre $1 billón y $1,5 billones, por debajo de los $2 billones que se habían mencionado. Las cifras detrás de esa oferta, incluidos los $895.400 millones en compromisos de cómputo, están en nuestro análisis del S-1 enmendado de Anthropic, publicado en inglés. ## Prueba una tarea difícil con esfuerzo alto
En la API, toma una tarea difícil que ya ejecutas en Opus 5.5 con su ajuste máximo, córrela en claude-fable-5-2 con esfuerzo alto y compara resultados aceptados por dólar, no puntos de benchmark. En las apps, recuerda que el esfuerzo medio es el valor por defecto y que las mejores cifras de Anthropic salieron con esfuerzo alto, Xhigh o máximo.
Queda pendiente la réplica: Anthropic no ha dicho quién ejecutó el puntaje de 49,1% en FrontierCode más allá de su propia tabla.
Actualización, 9 de noviembre de 2026: GitHub puso Fable 5.2 en disponibilidad general en Copilot, donde los administradores de Business y Enterprise deben activar una política que acepta la retención de datos de Anthropic; nuestra nota sobre Claude Fable 5.2 en GitHub Copilot, la política de administrador y el precio en Copilot incluye las tarifas y el plazo de fin de año para la retención cero.
Fuente: Anthropic, Introducing Claude Fable 5.2 and Claude Mythos 5.2
Últimas
- 01OPI de Anthropic: retira el rango de $70 a $80 por acciónNegocios · 2026-11-10
- 02Project Zenith en AMD Ryzen AI Halo: Windows 11 para programarProductos · 2026-11-10
- 03Demanda colectiva contra Nvidia por las declaraciones sobre HuangNegocios · 2026-11-10
- 04Claude Fable 5.2 en GitHub Copilot: política y precioProductos · 2026-11-10
- 05Jensen Huang y Megaspeed: la cronología completa, dato por datoNegocios · 2026-11-09